Ming Image 0.1 Design: Åpen designmodell med lag og MIT-lisens – men den er tyngre enn den ser ut
Ant Group har sluppet en bildemodell laget for brukergrensesnitt, infografikk og plakater, med lesbar tekst og gjennomsiktig bakgrunn. Lisensen er så fri som den kan bli. Maskinvarekravet er det ikke.
En bildemodell for design, ikke fotografi
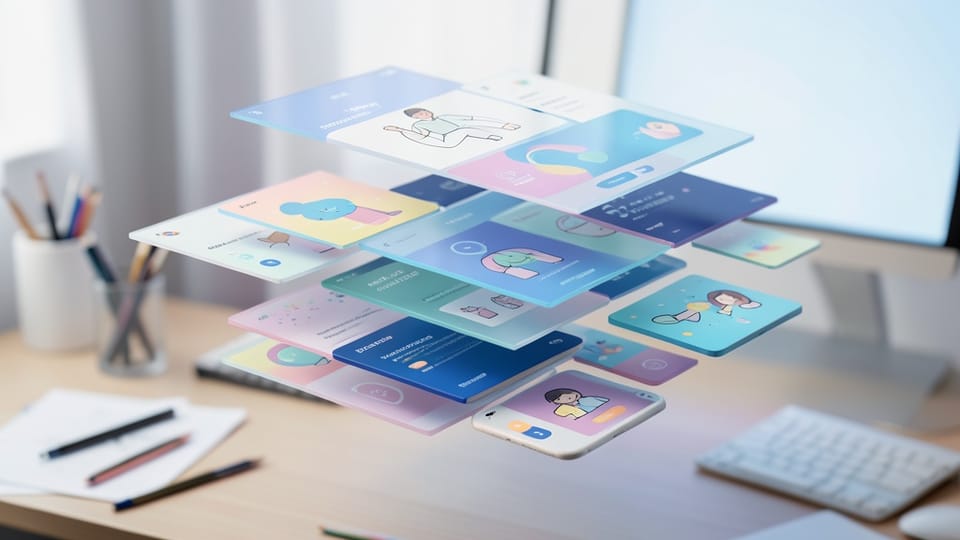
De fleste bildemodeller er laget for å lage pene bilder. Ming Image 0.1 Design fra inclusionAI, forskningsgruppen i Ant Group som også står bak Ling-språkmodellene, er laget for noe annet: design der teksten må være lesbar og oppsettet ryddig. Tenk skjermbilder av apper, dashbord, infografikk, produktplakater og logoark.
Modellen har 6 milliarder parametere og bygger på Z-Image-arkitekturen. Den lager bilder i 2048×2048, eller 1024×1024 hvis du vil gå raskere, og kan levere RGBA – altså med gjennomsiktig bakgrunn, slik at elementer kan legges rett inn i et annet design. Modellen kom 22. september.
Lagmodellen er det mest interessante
Søstermodellen Ming Image 0.1 Design Layer gjør noe vi sjelden ser i åpne modeller. Du gir den et ferdig, flatt designbilde og en lagplan – en beskrivelse av hvilke deler du vil ha skilt ut – og den deler bildet opp i mellom to og ni separate lag med gjennomsiktighet. Bakgrunn, tekst, knapper og illustrasjoner kan dermed redigeres hver for seg.
For alle som har prøvd å endre én detalj i et AI-generert design, er det her verdien ligger. I stedet for å generere hele bildet på nytt kan du flytte eller bytte ut ett element.
MIT-lisens – på ordentlig
Begge modellene er sluppet under MIT-lisensen. Det betyr at du kan bruke dem og bildene du lager kommersielt, uten egne avtaler. Det er en tydelig kontrast til Qwen Image 2.1, som kom samtidig, men som bare er lov å bruke til forskning og testing.
Maskinvaren: her må råteksten korrigeres
Råteksten vi fikk inn påsto at modellen er på 12 GB og «passer de fleste moderne GPU-er». Det stemmer bare for halve regnestykket.
Selve bildemodellen er riktignok 12,3 GB i full presisjon, og 6,2 GB i ComfyUIs int8-versjon. Men den trenger en tekstencoder – Ling-mini-2.0 – og den er mye større: 36,7 GB i full presisjon, 19,5 GB i int8 og 12,8 GB i den mest komprimerte w4a8-versjonen. inclusionAI har selv bare validert det offisielle oppsettet på ett grafikkort med 80 GB minne.
ComfyUI har pakket modellen om med mindre versjoner, og i praksis betyr det at du kan få den til å kjøre på et 24 GB-kort ved å bruke int8-modellen og den komprimerte tekstencoderen, gjerne med deler lagt over i vanlig RAM. Med 8–12 GB VRAM blir det tungt. Regn også med rundt 20 GB nedlasting som minimum.
Topper den virkelig listene?
Råteksten sa at modellen «topper UI/UX design-leaderboardet». Ifølge inclusionAI ligger den øverst blant åpne modeller på Artificial Analysis sin rangering av UI/UX-design, som bygger på blinde stemmer fra brukere. Det er altså førsteplass blant åpne modeller – ikke totalt. Slike Elo-rangeringer flytter seg også etter hvert som nye modeller og stemmer kommer til, og uavhengige tester av modellen er foreløpig få.
Dokumentasjonen var dessuten mangelfull ved lansering, med lenker som ikke virket. Det har bedret seg, og ComfyUI-pakken har allerede over 100 000 nedlastinger. Men forvent litt prøving og feiling.
Verdt å teste?
Ja, hvis du lager grensesnitt, presentasjoner eller grafikk og har et grafikkort med 24 GB eller mer. Kombinasjonen av lesbar tekst, gjennomsiktig bakgrunn, lagdeling og en lisens som faktisk tillater kommersiell bruk, finnes ikke andre steder i åpne modeller akkurat nå. Har du mindre minne, er det verdt å vente på flere komprimerte versjoner.
Ressurser
- Ming-Image-0.1-Design på Hugging Face – offisiell modell og innstillinger
- Ming-Image-0.1-Design-Layer på Hugging Face – lagmodellen
- Comfy-Org/Ming-Image – ComfyUI-filer i bf16, int8 og w4a8
- Ming-Image på GitHub – kode og installasjon