PolarQuant og QJL: Matematikken bak TurboQuant
TurboQuant er ikke én teknikk – det er to separate algoritmer som jobber i sekvens. Forstår du hvordan PolarQuant og QJL fungerer, forstår du hvorfor TurboQuant er annerledes.
PolarQuant: En ny vinkel på vektorer
Tradisjonell vektorkomprimering krever at modellen beregner og lagrer normaliseringskonstanter for hvert lille datablock. Det er overhead som delvis spiser opp gevinsten ved komprimeringen.
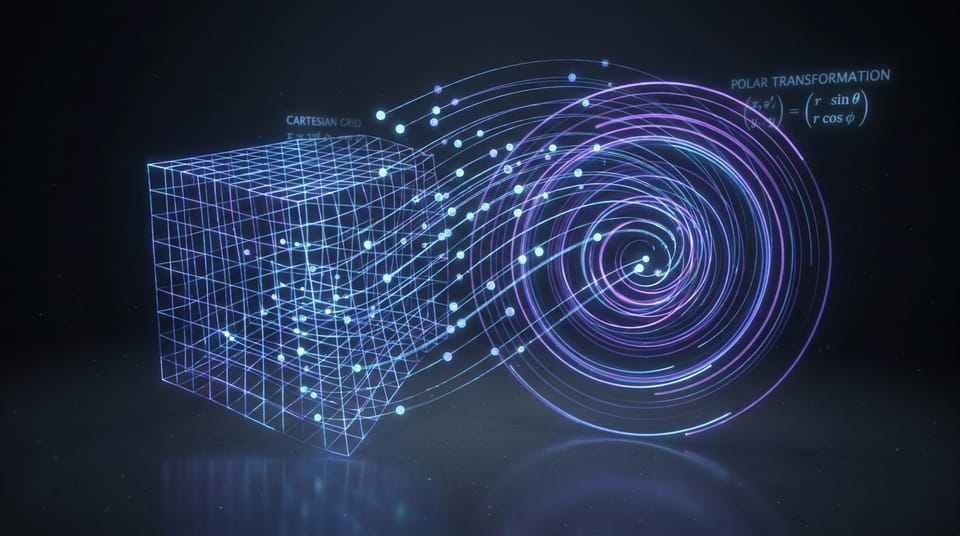
PolarQuant løser dette ved å rotere datavektorene tilfeldig først. Det forenkler geometrien slik at modellen kan kvantisere hver del av vektoren individuelt – uten å trenge per-blokk normalisering. Resultatet lagres som to verdier: en radius som beskriver signalstyrken, og en vinkel som beskriver retningen eller betydningen. Fordi vinkelmønsteret er kjent og forutsigbart, vet modellen allerede hvor grensene går – ingen dyr normaliseringsberegning nødvendig.
Dette første trinnet bruker hoveddelen av komprimeringskraften og bevarer kjernen av den semantiske informasjonen intakt. PolarQuant presenteres ved AISTATS 2026.
QJL: Én bit som fanger opp resten
QJL står for Quantized Johnson-Lindenstrauss – en matematisk teknikk som komprimerer høydimensjonale data mens den bevarer de viktige avstandsforholdene mellom datapunkter.
Der PolarQuant tar seg av hoveddelen, håndterer QJL den lille feilen som gjenstår. Den reduserer hvert tall til ett enkelt fortegnsbit – pluss eller minus. Null minneoverhead. For å opprettholde nøyaktigheten bruker QJL en spesiell estimator som balanserer høy presisjon i spørringen mot den forenklede dataen. Resultatet er et korrekt attention score selv etter aggressiv komprimering.
Kombinasjonen som gir 6x minnereduksjon
I testing oppnår TurboQuant KV-cache-komprimering ned til 3 bits – uten trening, uten finjustering, og uten tap av modellnøyaktighet. På H100 GPU-er gir 4-bits TurboQuant opptil 8x ytelsesøkning sammenlignet med ukomprimerte 32-bits nøkler.
Det er dette som gjør kombinasjonen relevant for minnekrisen i AI-industrien: ikke bare at det virker, men at det virker uten å kreve ny trening av eksisterende modeller.
Ressurser: TurboQuant – Google Research · PolarQuant – arXiv · QJL – arXiv