Steg, CFG og seed: Hva innstillingene i bildegeneratoren faktisk gjør – vist med egne testbilder
Tre tall styrer det meste av resultatet når du lager bilder i ComfyUI: antall steg, CFG og seed. Mange råd på nettet er skrevet for eldre modeller og stemmer ikke lenger. Vi testet med samme prompt på vår egen maskin, så du kan se forskjellen.
Slik testet vi
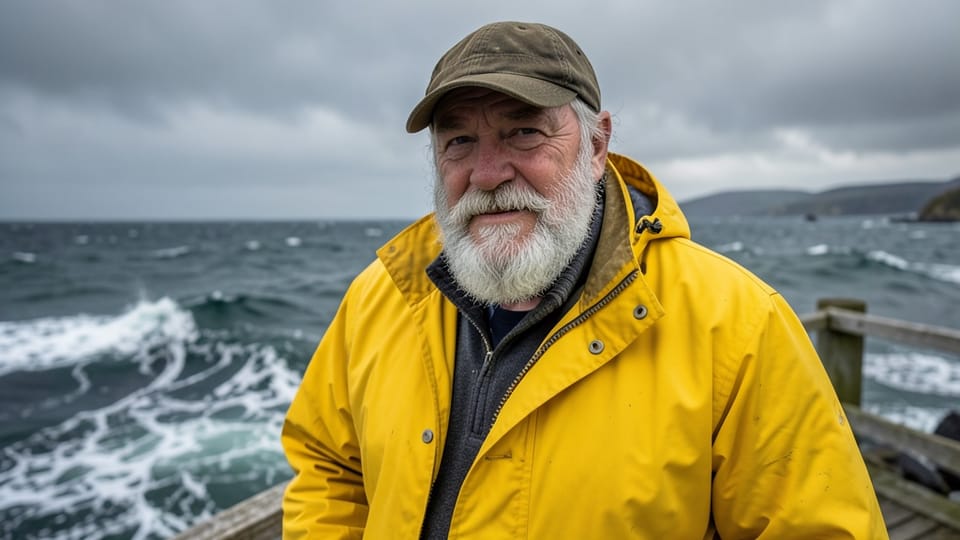
Alle bildene er laget på hjemmeserveren vår med et RTX 3090, i 1024×576 piksler, med denne prompten:
«Portrett av en gammel norsk fisker med grått skjegg og gul regnjakke på en trebrygge, stormfullt hav i bakgrunnen, overskyet lys.»
For steg og seed brukte vi Flux 2 Klein 4B, for CFG Z-Image Turbo. Begge er moderne, destillerte modeller – den typen de fleste bruker i dag. Vi har sammenlignet dem i en egen test.
Steg: hvor mange ganger bildet pusses
En bildemodell starter med ren støy og fjerner litt av den i hvert steg, til det står igjen et bilde. Flere steg betyr flere runder med finpuss – og lengre tid.
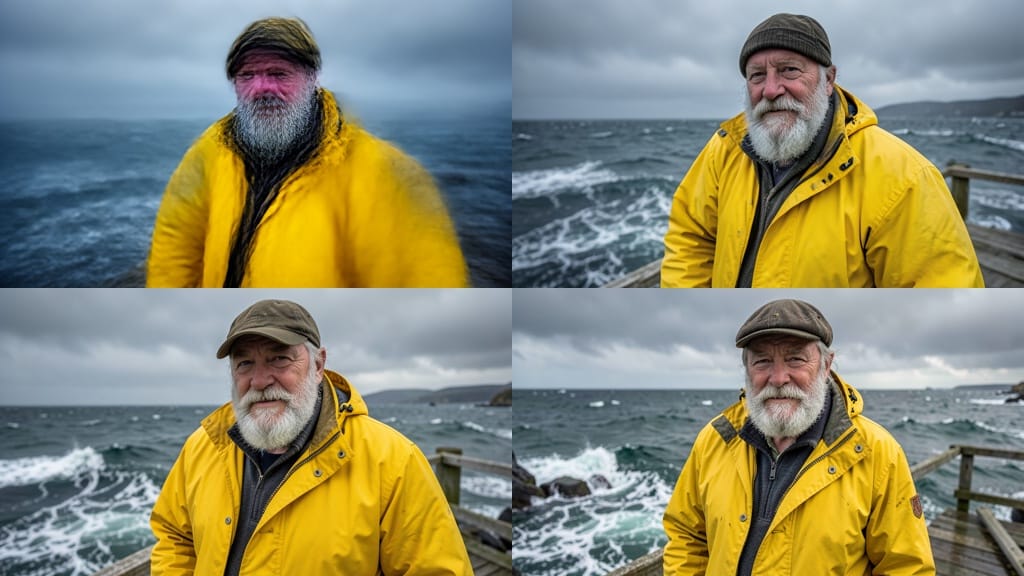
Flux 2 Klein 4B med 1 steg (øverst til venstre), 2, 4 og 8 steg (nederst til høyre). Samme seed.
Med ett steg får du en uskarp skisse med feil farger i ansiktet. Allerede med to steg er bildet brukbart, og fire – som er standard for denne modellen – gir et ferdig resultat. Åtte steg gir litt mer kontrast og detaljer i bølgene, men forskjellen er liten.
Poenget: Destillerte modeller er trent for et bestemt antall steg, og mer er ikke automatisk bedre. Bruk det modellen anbefaler – 4 for Flux 2 Klein, 8 for Z-Image Turbo, 25 for Qwen Image 2.1 – og øk bare hvis du ser at noe mangler.
CFG: hvor hardt modellen styres mot prompten
CFG (classifier-free guidance) bestemmer hvor mye modellen dras mot det du har skrevet, sammenlignet med et bilde uten prompt. Råteksten vi fikk inn ga det klassiske rådet: Skru CFG opp for å få modellen til å følge prompten mer nøyaktig. Det stemte for eldre modeller som Stable Diffusion XL, som gjerne brukes med CFG mellom 4 og 8. For dagens destillerte modeller er det feil.
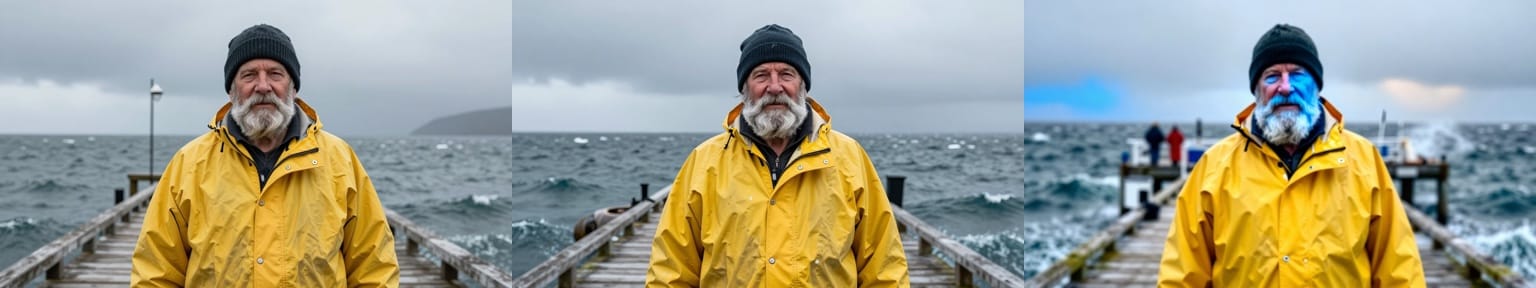
Z-Image Turbo med CFG 1, 2 og 4. Samme seed.
Med CFG 1 – som er anbefalt for modellen – får vi et naturlig bilde. Med CFG 2 blir kontrasten litt kraftigere, ellers er bildet nesten likt. Med CFG 4 går det galt: Ansiktet blir blått, himmelen får rare fargeflekker og det dukker opp figurer som ikke hører hjemme der. Modellen er trent for å klare seg uten ekstra styring, og når du presser den, går fargene over styr.
To ting til er verdt å vite. Med CFG over 1 må modellen regne to ganger per steg – i vår test gikk tiden fra rundt 5 til 9 sekunder per bilde. Og med CFG nøyaktig 1 hopper ComfyUI over den negative prompten helt, så det du skriver der, har ingen effekt.
Seed: startpunktet for støyen
Seed er tallet som bestemmer hvordan startstøyen ser ut. Samme prompt, samme innstillinger og samme seed gir det samme bildet hver gang. Endrer du bare seed, får du en ny variant.
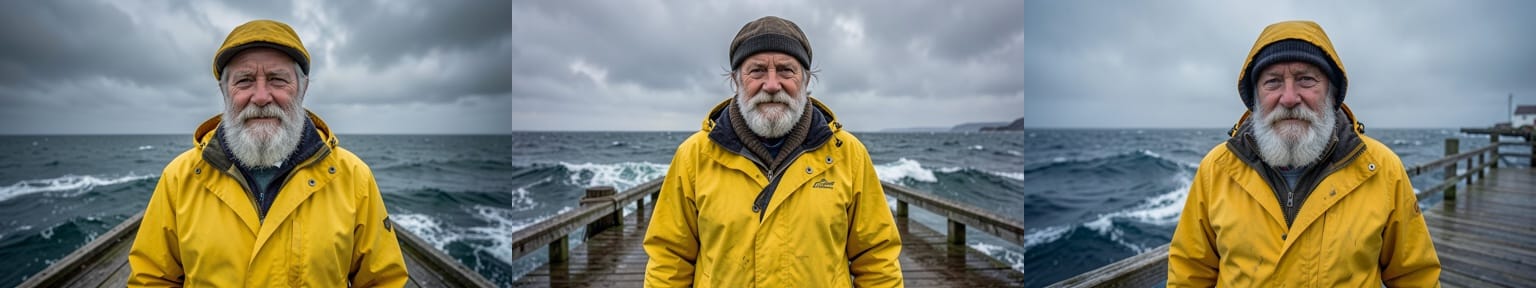
Flux 2 Klein 4B med seed 101, 202 og 303. Alt annet er likt.
Fiskeren er gjenkjennelig i alle tre, men lua, vinkelen på brygga og bølgene er forskjellige. Det gjør seed til et nyttig verktøy: Prøv flere seeds for å finne en komposisjon du liker, og lås deretter seed når du justerer prompten, slik at du ser effekten av endringen og ikke av tilfeldighetene.
Kort oppsummert
- Steg: Bruk modellens anbefaling. Flere steg er sjelden verdt tiden med destillerte modeller.
- CFG: Hold deg på 1 for Flux 2 Klein, Z-Image Turbo og Qwen Image 2.1. Høyere CFG er for eldre modeller.
- Seed: Variér for å utforske, lås for å sammenligne.
- Følger ikke modellen prompten? Skriv prompten tydeligere i stedet for å skru på CFG.
Ressurser
- ComfyUI-dokumentasjon: Qwen-Image-2.1 – anbefalte innstillinger og forklaring av CFG 1
- FLUX.2 Klein 4B på Hugging Face – modellen vi brukte for steg og seed
- Z-Image Turbo på Hugging Face – modellen vi brukte for CFG